통계 : Dummy Variable Trap 기본 콘텐츠로 건너뛰기

통계 : Dummy Variable Trap

 Regression model을 만들다 보면, 독립변수로 명목형 변수를 사용할 때가 많다. 지역이나 성별, biomaker유/무 등이 대표적으로 많이 사용되는 명목형 변수로, 특히 medical 저널에서는 성별을 covariate으로 취급하여 성별에 따른 종속변수의 차이를 보고자 할 때가 많다.


명목형 변수들은 Dummy Variable로 바꾸어서 regression model을 만드는데, one hot 인코딩 방식으로 더미 변수들을 만든다.

예를 들면, 

male=0, female=1

Biomarker유=1, Biomarker무=0

이런식으로 만든다.

이와 같은 binary 데이터들은 더미 변수로 만드는 것도 쉽고 큰 문제가 되지 않는다.


one-hot encoding의 이유는, 0과 1 대신 빨간색, 녹색, 파란색을 1,2,3 으로 코딩해버리면, 적합한 모델은 숫자가 더 큰 3을 빨간색보다 더 중요한 인자로 생각하게 되기 때문이다. 학력처럼 순서형이면 각 숫자에 의미가 있지만 여러 컬러처럼 단순 명목형일 때에는 one-hot 인코딩을 해야한다. 

(단, 컬러가 연함 - 진함과 같이 순서형이라면 굳이 one-hot 인코딩을 안해도 된다.)


one-hot encoding의 예시는 아래 세 가지 카테고리로 보면 더 명확하게 이해가 된다.

(image출처: https://towardsdatascience.com/encoding-categorical-variables-one-hot-vs-dummy-encoding-6d5b9c46e2db)


그럼 binary 말고 여러 카테고리가 있는 변수의 경우는 어떤 식으로 더미 변수를 만들까?

Regression 모델을 만들 때에는 k개의 카테고리가 있다면, k-1개의 더미변수를 생성하게 된다. 위 그림에서 Blue일 때, d1, d2, d3 모두 0으로 코딩해도 Red, Green과 차이가 있으므로, d1과 d2만 만들어도 무방하다는 의미이다. 즉, d1과 d2가 0일 때, Blue가 되는 것이다.

이것도 예를 들어 보면 쉽게 이해가 되는데,

명목형 변수 중에 지역이나 부서 같은 여러 카테고리가 있는 변수를 생각해보자.

IT부서, 회계부서, 유통부서, 영업부서, AS부서, 기획부서 이렇게 6개의 부서가 있다고 하자.

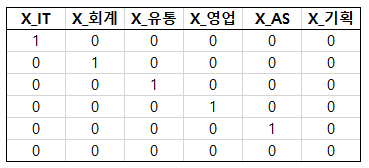
그럼 총 6개의 카테고리를 다음과 같이 one-hot encoding 할 수 있다.
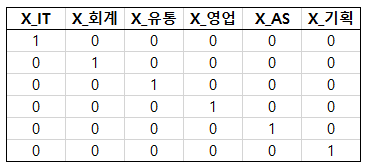

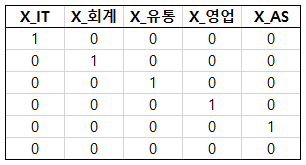
그런데 앞서 언급했듯이 카테고리가 6개라면, 더미 변수는 5개만 있어도 상관없다. 맨 마지막 기획부서를 전부 0으로 해도 무방하기 때문에 모델 적합의 편의성을 위해 맨 마지막 X_기획을 0으로 코딩하면 다음과 같다.

이는 또 다음과 같이 만들 수 있다.


그럼 굳이 왜 이와 같이 인코딩을 해주는 것일까?
'그냥 카테고리마다 1로 해주면 되지 않을까?' 라는 생각이 드는데, 굳이 이와 같이 코딩을 해주는 이유는 multicollinearity 때문이다. 다중공선성은 독립변수 간의 상관계수가 높을 때 발생하는데, 독립변수 A와 독립변수 B의 상관성이 높다면 A를 통해서 B도 추측이 가능하기 때문에 regression 모델의 회귀계수 해석에 어려움이 생긴다.


댓글

이 블로그의 인기 게시물

민감도와 특이도 - 예측력 측도

민감도와 특이도   Predicted Total Pos Neg Actual Pos a b a+b Neg c d c+d 민감도 sensitivity 는 조건부확률로 실제 양성일 때, 양성으로 판정할 확률이다. $$ Sensitivity = P(Y=1|X=1) , Specificity = P(Y=0|X=0) $$ 이를 위 표에 적용해보면 민감도는 $$ \frac{a}{a+b} $$ 특이도 specificity 는 실제 음성일 때 음성으로 판정할 확률이다. 위 표로부터 구한 특이도는 다음과 같다. $$ \frac{c}{c+d} $$ 따라서 민감도와 특이도가 높을수록 예측력이 좋다고 할 수 있다.

GLM과 이탈도 - 모형검정 & 적합도검정

 GLM에서 이탈도 이탈도 Deviance란 무엇일까? GLM에서 이탈도 deviance는 선형회귀모형에서 잔차제곱합에 대응하는 값으로 표본과 적합된 모형 간 편차를 정량화 하는 값이다. GLM에서 이탈도로 할 수 있는 검정이 무엇이 있을까? 1. 모형의 유의성 검정 2. 모형의 적합도평가 GLM 모형을 적합하면 다음과 같은 결과가 나오는데, 이탈도 값은 2개가 나온다. ①Null deviance ②Residual deviance 이 두 개의 이탈도 값이다. ①Null deviance는 절편만 있는 모형에서의 이탈도 ②Residual deviance는 β  가 포함된 모형에서의 이탈도를 의미한다. 먼저 ① 모형의 유의성 검정 을 살펴보겠다. 유의성 검정에서의 귀무가설과 대립가설은 다음과 같다. 귀무가설:  β1  =  β2  = 0 (Null model) 대립가설: 적어도 하나는 0이 아니다. 이를 검정하기 위한 검정통계량 LR(=가능도비 검정통계량) 은 다음과 같다. LR = [Null deviance] - [Residual deviance] = 2(현재모형 하에서 로그가능도 함수의 최댓값 - 귀무가설 하에서 로그가능도 함수의 최댓값) 따라서 이를 위 적합 결과에 적용하면 $$ LR = 225.76 - 189.12 = 36.64 $$ $$ 1 - pchisq(36.64, df=2) = 1.1(10)^{-8} $$ 결론: 유의확률이 매우 작으므로 귀무가설을 기각하고 대립가설을 선택할 수 있다. 모형의 유의성 검정에 대해 살펴보았으니 이번에는 두 번째인 ② 모형의 적합도 검정 을 살펴보자. 적합도 검정에서의 귀무가설과 대립가설은 다음과 같다. 귀무가설: 현재의 단순한 모형 M (=모형M에 포함되지 않은 모수들은 모두 0이다.) 대립가설: 포화모형 saturated model 이를 검정하기 위한 검정통계량은 이탈도 통계량으로 다음과 같이 정의한다. 이탈도 통계량 = 2[포화모형 로그가능도함수의 최댓값 ...