일치도 통계와 paired t-test 기본 콘텐츠로 건너뛰기

일치도 통계와 paired t-test

Why using a paired t test to assess agreement is problematic? by Nikolaos Pandis

https://doi.org/10.1016/j.ajodo.2021.07.001


Agreement를 평가함에 있어 paired t-test를 사용하는 논문들이 몇 있다. 

임상논문에서 의료기기가 측정한 것의 일치성, 혹은 의료행위자 A와 B가 측정한 것이 비슷한지를 측정하는 일들이 꽤 많은데, 여전히 많은 논문들에서 paired t-test에서 p>0.05 라는 통계 결과를 얻었을 때 '두 기기에서 측정한 수치는 일치한다.' 혹은 '의사A와 의사B가 측정한 수치는 일치한다.' 라는 결과를 내린다.


통계를 배울 때, "짝지어진 두 모집단의 차이를 보고 싶을 때는 paired t-test를 사용한다." 라고 많이들 배우는데, 아마 이렇게 배우기(?) 때문에 '그럼 paired t-test의 p-value가 0.05보다 크면 두 집단 간 차이가 없다는 것이겠네?'라고 많은 사람들의 생각이 이어지는듯하다.


그러나 내가 통계적으로 살펴보고 싶은 것이 "Agreement"라면 paired t-test를 사용하는 것은 잘못 되었다.


그 이유에 대해서는 다음 두 개의 시나리오를 이용해 설명해보도록 하겠다.
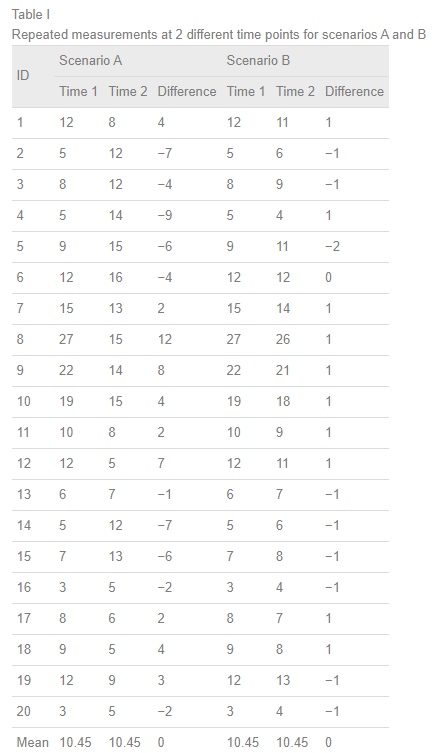

시나리오A와 시나리오B에는 시간 차이를 두고 같은 subject를 측정한 Time1 수치와 Time2 수치가 있다. 시나리오A와 시나리오B 모두 Time1과 Time2에서 측정된 수치의 평균은 10.45로 동일하다.


✔️먼저 시나리오A를 살펴보자.

시나리오A에서 Time1과 Time2의 평균은 10.45로 동일하므로, 차이 d의 평균도 0이고 따라서 paired t-test를 진행하면 p-value가 1로 나올 것이다. 

그럼 Time1과 Time2가 동일한 수치를 냈다고 결론지을 수 있는가?

시나리오A의 각 subject를 대상으로 시간 차이를 두고 측정한 Time1과 Time2는 [-9 ~ 12] 까지 꽤 큰 차이가 있다. 


✔️이번에는 시나리오B를 살펴보자. 

여기에서도 마찬가지로 Time1과 Time2의 평균은 10.45로 동일하며, 차이 d의 평균 역시 0이다. 그렇기에 시나리오B의 데이터로 paired t-test를 진행하면 p-value 1을 얻을 것이다. 시나리오A와 다른 점은 각 subject에서 Time1과 Time2의 차이가 [-2 ~ 1]로 훨씬 작다는 점이다.


paired t-test 결과, 시나리오B는 시나리오A와 같이 p-value가 1이므로 두 경우 모두 "불일치의 증거가 없다. -> 두 측정치는 일치한다."라고 결론 내릴 수 있을까?

Paired t-test의 귀무가설은 "두 그룹의 모평균의 차이는 없다." 이므로, 시나리오A에서 p-value가 1이기 때문에 귀무가설을 기각할 수 없고, 따라서 불일치의 증거가 없다는 잘못된 해석이다.


❌두 측정 간의 agreement를 통계적으로 측정하고자 할 때, paired t-test를 사용한다는 것부터 잘못되었다. 직관적으로도 시나리오A와 시나리오B에서 같은 결과를 내는 것은 잘못 되었다고 보인다.


✔️그럼 왜 이런 문제가 발생할까?

이러한 문제는 각각의 observation을 살펴보는 것이 아니고 "평균"을 살펴보기 때문에 발생한다. 예를 들어, 임상시험처럼 '투여군'과 '대조군' 간, 정말 전반적인 "그룹" 간의 차이가 중요할 때에는 paired t-test를 사용할 수 있다. 그러나 각 observation의 차이가 중요한 Agreement를 살펴보고자 할 때 paired t-test를 사용하면 위의 예시처럼 평균의 함정에 빠질 수 있다.


댓글

이 블로그의 인기 게시물

민감도와 특이도 - 예측력 측도

민감도와 특이도   Predicted Total Pos Neg Actual Pos a b a+b Neg c d c+d 민감도 sensitivity 는 조건부확률로 실제 양성일 때, 양성으로 판정할 확률이다. $$ Sensitivity = P(Y=1|X=1) , Specificity = P(Y=0|X=0) $$ 이를 위 표에 적용해보면 민감도는 $$ \frac{a}{a+b} $$ 특이도 specificity 는 실제 음성일 때 음성으로 판정할 확률이다. 위 표로부터 구한 특이도는 다음과 같다. $$ \frac{c}{c+d} $$ 따라서 민감도와 특이도가 높을수록 예측력이 좋다고 할 수 있다.

통계 : Dummy Variable Trap

 Regression model을 만들다 보면, 독립변수로 명목형 변수를 사용할 때가 많다. 지역이나 성별, biomaker유/무 등이 대표적으로 많이 사용되는 명목형 변수로, 특히 medical 저널에서는 성별을 covariate으로 취급하여 성별에 따른 종속변수의 차이를 보고자 할 때가 많다. 명목형 변수들은 Dummy Variable로 바꾸어서 regression model을 만드는데, one hot 인코딩 방식으로 더미 변수들을 만든다. 예를 들면,  ❕ male=0, female=1 ❕ Biomarker유=1, Biomarker무=0 이런식으로 만든다. 이와 같은 binary 데이터들은 더미 변수로 만드는 것도 쉽고 큰 문제가 되지 않는다. one-hot encoding의 이유는, 0과 1 대신 빨간색, 녹색, 파란색을 1,2,3 으로 코딩해버리면, 적합한 모델은 숫자가 더 큰 3을 빨간색보다 더 중요한 인자로 생각하게 되기 때문이다. 학력처럼 순서형이면 각 숫자에 의미가 있지만 여러 컬러처럼 단순 명목형일 때에는 one-hot 인코딩을 해야한다.  (단, 컬러가 연함 - 진함과 같이 순서형이라면 굳이 one-hot 인코딩을 안해도 된다.) one-hot encoding 의 예시는 아래 세 가지 카테고리로 보면 더 명확하게 이해가 된다. (image출처: https://towardsdatascience.com/encoding-categorical-variables-one-hot-vs-dummy-encoding-6d5b9c46e2db) 그럼 binary 말고 여러 카테고리가 있는 변수의 경우는 어떤 식으로 더미 변수를 만들까? Regression 모델을 만들 때에는 k개의 카테고리가 있다면, k-1개의 더미변수를 생성하게 된다. 위 그림에서 Blue일 때, d1, d2, d3 모두 0으로 코딩해도 Red, Green과 차이가 있으므로, d1과 d2만 만들어도 무방하다는 의미이다. 즉, d1과 d2가 0일 때, Blue가...

GLM과 이탈도 - 모형검정 & 적합도검정

 GLM에서 이탈도 이탈도 Deviance란 무엇일까? GLM에서 이탈도 deviance는 선형회귀모형에서 잔차제곱합에 대응하는 값으로 표본과 적합된 모형 간 편차를 정량화 하는 값이다. GLM에서 이탈도로 할 수 있는 검정이 무엇이 있을까? 1. 모형의 유의성 검정 2. 모형의 적합도평가 GLM 모형을 적합하면 다음과 같은 결과가 나오는데, 이탈도 값은 2개가 나온다. ①Null deviance ②Residual deviance 이 두 개의 이탈도 값이다. ①Null deviance는 절편만 있는 모형에서의 이탈도 ②Residual deviance는 β  가 포함된 모형에서의 이탈도를 의미한다. 먼저 ① 모형의 유의성 검정 을 살펴보겠다. 유의성 검정에서의 귀무가설과 대립가설은 다음과 같다. 귀무가설:  β1  =  β2  = 0 (Null model) 대립가설: 적어도 하나는 0이 아니다. 이를 검정하기 위한 검정통계량 LR(=가능도비 검정통계량) 은 다음과 같다. LR = [Null deviance] - [Residual deviance] = 2(현재모형 하에서 로그가능도 함수의 최댓값 - 귀무가설 하에서 로그가능도 함수의 최댓값) 따라서 이를 위 적합 결과에 적용하면 $$ LR = 225.76 - 189.12 = 36.64 $$ $$ 1 - pchisq(36.64, df=2) = 1.1(10)^{-8} $$ 결론: 유의확률이 매우 작으므로 귀무가설을 기각하고 대립가설을 선택할 수 있다. 모형의 유의성 검정에 대해 살펴보았으니 이번에는 두 번째인 ② 모형의 적합도 검정 을 살펴보자. 적합도 검정에서의 귀무가설과 대립가설은 다음과 같다. 귀무가설: 현재의 단순한 모형 M (=모형M에 포함되지 않은 모수들은 모두 0이다.) 대립가설: 포화모형 saturated model 이를 검정하기 위한 검정통계량은 이탈도 통계량으로 다음과 같이 정의한다. 이탈도 통계량 = 2[포화모형 로그가능도함수의 최댓값 ...