통계 기초 : 표준오차 vs 표준편차 (standard error & standard deviation) 기본 콘텐츠로 건너뛰기

통계 기초 : 표준오차 vs 표준편차 (standard error & standard deviation)

 통계를 살펴보면서 헷갈리는 것을 꼽으면 표준오차와 표준편차의 차이점을 들 수 있다.


표준편차와 표준오차에 대해 명확하게 나타낸 그림이 있어 가져왔다. 

(출처는 그림 안에 있음)
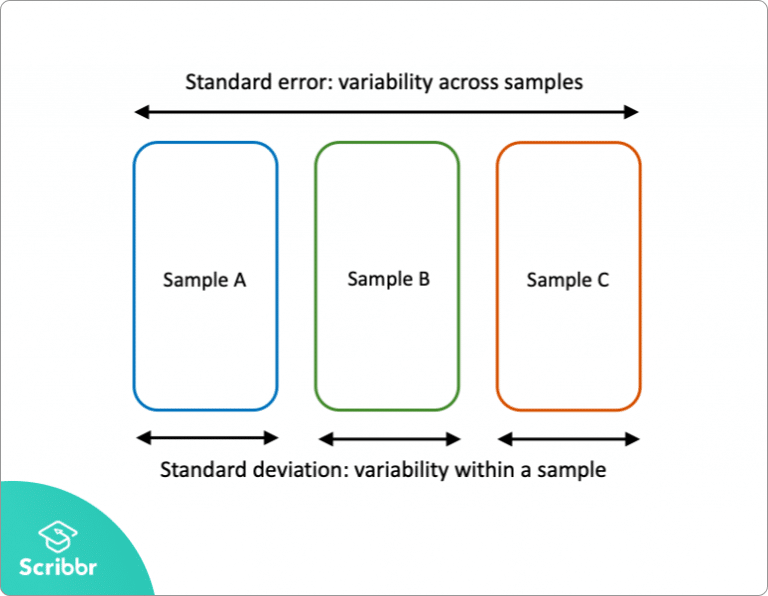

표준편차와 표준오차는 한국어로 표현했을 때, 단 한 글자의 차이밖에 없기 때문에 나만 그럴 수 있겠지만.. 더 헷갈린다.


먼저 표준편차에 대해서 살펴보자.

예를 들어, 전국의 성인 남녀의 몸무게를 조사하기 위해 1,000명을 랜덤으로 추출하고자 한다. 

여기에서 모집단은 전국의 성인 남녀이고, 표본은 랜덤으로 추출된 1,000명의 성인 남녀이다.

그럼 표본의 크기가 1,000인 성인 남녀의 몸무게의 평균을 62kg, 표준편차는 4.5kg라 하자.


𝓧¡ 를 표본조사를 통해 얻은 각 관측치라고 할 때, 표준편차의 제곱을 구하는 식은 다음과 같다.

$$ S^2=\frac{\sum_{i=1}^{n}(x_i-\overline{x})^2}{n-1} $$

위 수식을 통해 표준편차란, 표본 조사로 얻은 각 관측값과 표본평균의 차이를 나타낸다고 할 수 있다. 

모집단의 표준편차를 구할 때에는 분모에 n-1 대신 n으로 나누면 된다.


이번에는 표준오차를 살펴볼 차례이다.

바로 표준오차의 수식을 살펴보자.

$$ SE=s/\sqrt{n} $$

표준오차는 표준편차를 표본크기의 제곱근으로 나눈 값이다. 따라서 표본의 크기(n)가 커질수록 표준오차의 값은 작아진다.


그럼 표준오차는 무엇을 의미할까? 표준오차는 "표본평균들의 편차"를 의미한다. 

원래 샘플링 오류를 줄이기 위해서 모집단에서 여러 번 표본추출을 하여 여러 표본 그룹이 있어야 하지만 현실적인 이유로 이는 불가능한 경우가 대다수다.

대부분의 경우는 모집단에서 한 번의 표본추출을 하고, 이 표본들이 모집단을 대표한다고 추정한다. 따라서 위의 예시와 같이 표본 1,000명이라는 표본의 크기 n과, 이 표본의 표준편차인 4.5kg를 이용하여 표준오차를 구하게 된다. 

따라서 위 예시에서 표준오차는 4.5/√1000 ≒ 1.423이다.


표본의 수가 충분히 크면 중심극한정리에 의해 표준평균은 정규분포를 따르므로, 이를 통해 95% 신뢰구간을 구하자면, [62 ± (1.96*1.423)]가 된다.


댓글

이 블로그의 인기 게시물

민감도와 특이도 - 예측력 측도

민감도와 특이도   Predicted Total Pos Neg Actual Pos a b a+b Neg c d c+d 민감도 sensitivity 는 조건부확률로 실제 양성일 때, 양성으로 판정할 확률이다. $$ Sensitivity = P(Y=1|X=1) , Specificity = P(Y=0|X=0) $$ 이를 위 표에 적용해보면 민감도는 $$ \frac{a}{a+b} $$ 특이도 specificity 는 실제 음성일 때 음성으로 판정할 확률이다. 위 표로부터 구한 특이도는 다음과 같다. $$ \frac{c}{c+d} $$ 따라서 민감도와 특이도가 높을수록 예측력이 좋다고 할 수 있다.

범주형 변수 ; Categorical Variables

 범주형 변수 (categorical variables)의 정의와 예시에 대해 살펴보고 다음 글부터 범주형 변수의 분석 방법에 대해 다루고자 한다. ✅범주형 변수 의 정의: 측정 단위가 여러 범주들의 집합으로 구성되어 있는 변수 범주형 변수는 질적 변수 (qualitative variables) 라고도 일컬어 진다. 📋범주형 변수의 예시 ex 1) 영화장르: 액션 - 로코 - 코미디 - 드라마 ex 2) 백신 접종 여부: 예 - 아니오 ex 3) 최종 학력: 중졸 - 고졸 - 전문대졸 - 대졸 - 대학원졸 ex 4) 행복 수준: 없음 - 가끔 - 꽤 행복 - 항상 행복 범주형 변수는 하위 세 가지 타입의 변수를 갖는다. 1. 이항변수 (Binary variables)        ⇨ 위 예시 2번이 해당       ⇨ [예 or 아니오] 혹은 [찬성 or 반대] 두 가지의 범주만을 갖는 변수들 2. 명목형변수 (Nominal variables)        ⇨ 위 예시 1번이 해당      ⇨ 3개 이상의 범주를 갖고 변수들 사이에 순서에 대한 의미가 없는 변수들 3. 순서형변수 (Ordinal variable)        ⇨ 위 예시 3번과 4번이 해당     ⇨ 범주들이 일정한 순서를 갖는 변수들 (순서에 의미가 있음)  범주형 변수들을 어떻게 분석할 것인가?     ⇨ GLM (Generalised Linear Model) 일반화 선형모형 이용함. 자세한 분석 방법들은 다음 글들에서 다루고자 한다.

Odds Ratio and Relative Risk ; 오즈비와 상대위험도 part. 2

 지난 글에서 2X2 분할표에서 많이 사용되는 오즈비와 상대위험도의 개념에 대해서 살펴보았다. 그 중에서도 지난 글에서는 오즈비를 사용할 수밖에 없는 경우에 대해 살펴보았다.  상대위험도가 직관적으로 이해하기 쉽고 위험비에 대한 쉬운 해석을 가능하게 하지만, 그럼에도 불구하고 보건 or 의학 계열에서 오즈비를 많이 사용 할 수밖에 없는 이유에 대해 살펴보았다. 또한 오즈비와 상대위험도는 가끔 동일하게 해석되기도 한다. (자세한 내용은 이전 글로..) 그럼 이번 글에서는 오즈비와 상대위험도를 동일하게 해석할 수 있는 경우 에 대해 살펴보도록 하겠다. 먼저 다음과 같은 오즈비의 특성을 이해해야 한다. 오즈비의 중요 특성: 상대적인 위험도를 과장하는 측면 이 있다. 이는 굉장히 중요한 오즈비의 특성인데, Relative Risk 값보다 항상 큰 값을 가진다. 그리고 이는 해당 Event가 흔하게 일어날 수록 더욱 더 과장 된다. 📋예를 들어 보자. 따듯한 차를 마셨을 때와 방안 온도의 차를 마셨을 때 체온이 상승하는지 아니면 그대로 유지되는지에 대해 조사하고 다음과 같은 분할표를 얻었다.   체온 상승 유지 Total Warm tea 90 10 100 Normal temp 20 180 200 먼저 Relative Risk 상대위험도 를 구해보자. $$ \frac{90/100}{20/200} = 9 $$ 이번엔 Odds Ratio 오즈비 를 구해보자. (유도과정은 이전 글 참고) $$ \frac{90 * 180}{20 * 10} = 81 $$ 이번엔 방금 구한 상대위험도와 오즈비를 해석해보자. 📉 RR : 상대위험도는 9로, 이는 따듯한 차를 마신다면 체온이 상승할 확률이 방안 온도의 차를 마셨을 때보다 체온이 상승할 확률...